Oefen sollicitatiegesprekken met een AI-coach die je privacy bewaakt
Interview Coach bereidt je voor op één concrete vacature: een briefing, een oefengesprek waarin een AI-interviewer doorvraagt op je antwoorden, en een eerlijke terugblik met scores, bronnen en een oefenplan.
Deze pagina laat een complete oefenronde zien van een fictieve kandidaat. Je kunt de app ook zelf proberen; kies hoe je begint:
Zelf proberen
Gebruikersnaam en wachtwoord, geen e-mail. Je uploadt een vacature en je cv en voert een gesprek van 15 tot 45 minuten.
Het lokale model is nu online.
Wat je kunt verwachten ↓Eerst rondkijken
De drie stappen van een ronde, met schermafbeeldingen, en daarna het echte resultaat van deze ronde.
Op deze pagina zelf vul je niets in; ze is alleen om te bekijken.
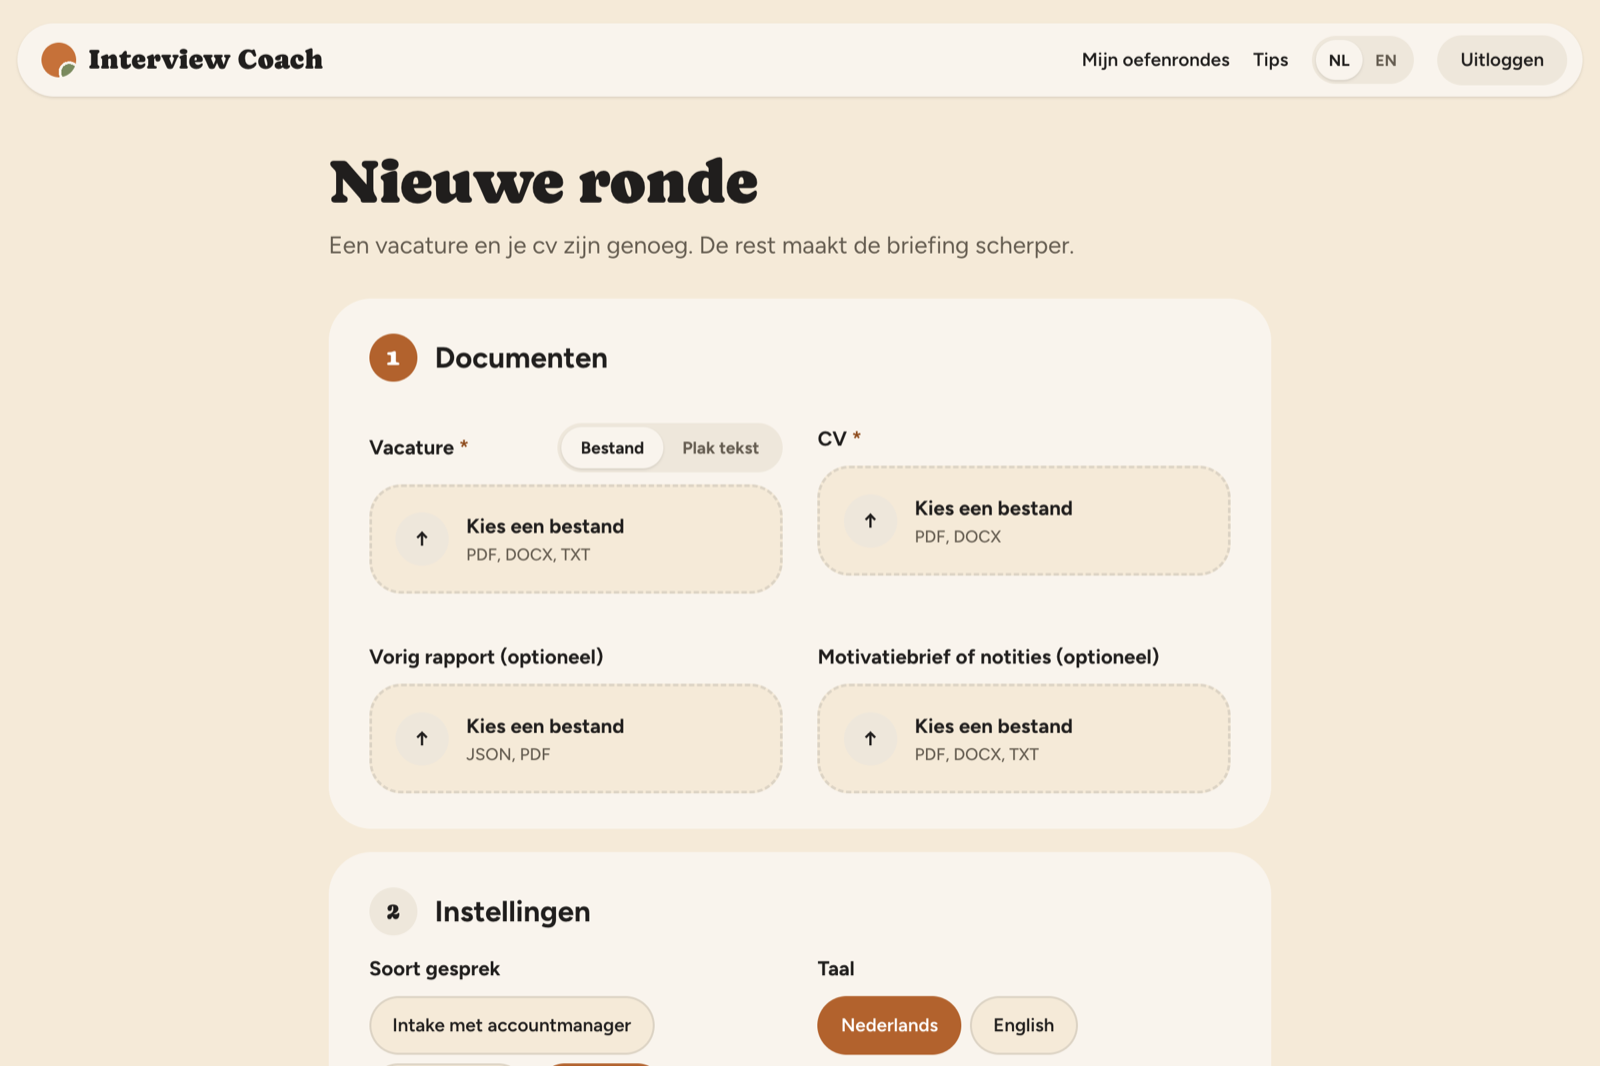
- VoorbereidenUpload vacature en cv. De app zoekt per eis het bewijs in je cv en schrijft een briefing.
 Schermafbeelding
Je begint met de vacature en je cv. De voorbereiding duurt ongeveer 3 minuten. - OefenenEen gesprek van 15 tot 45 minuten, getypt of gesproken, met vervolgvragen op jouw antwoorden.
 Schermafbeelding
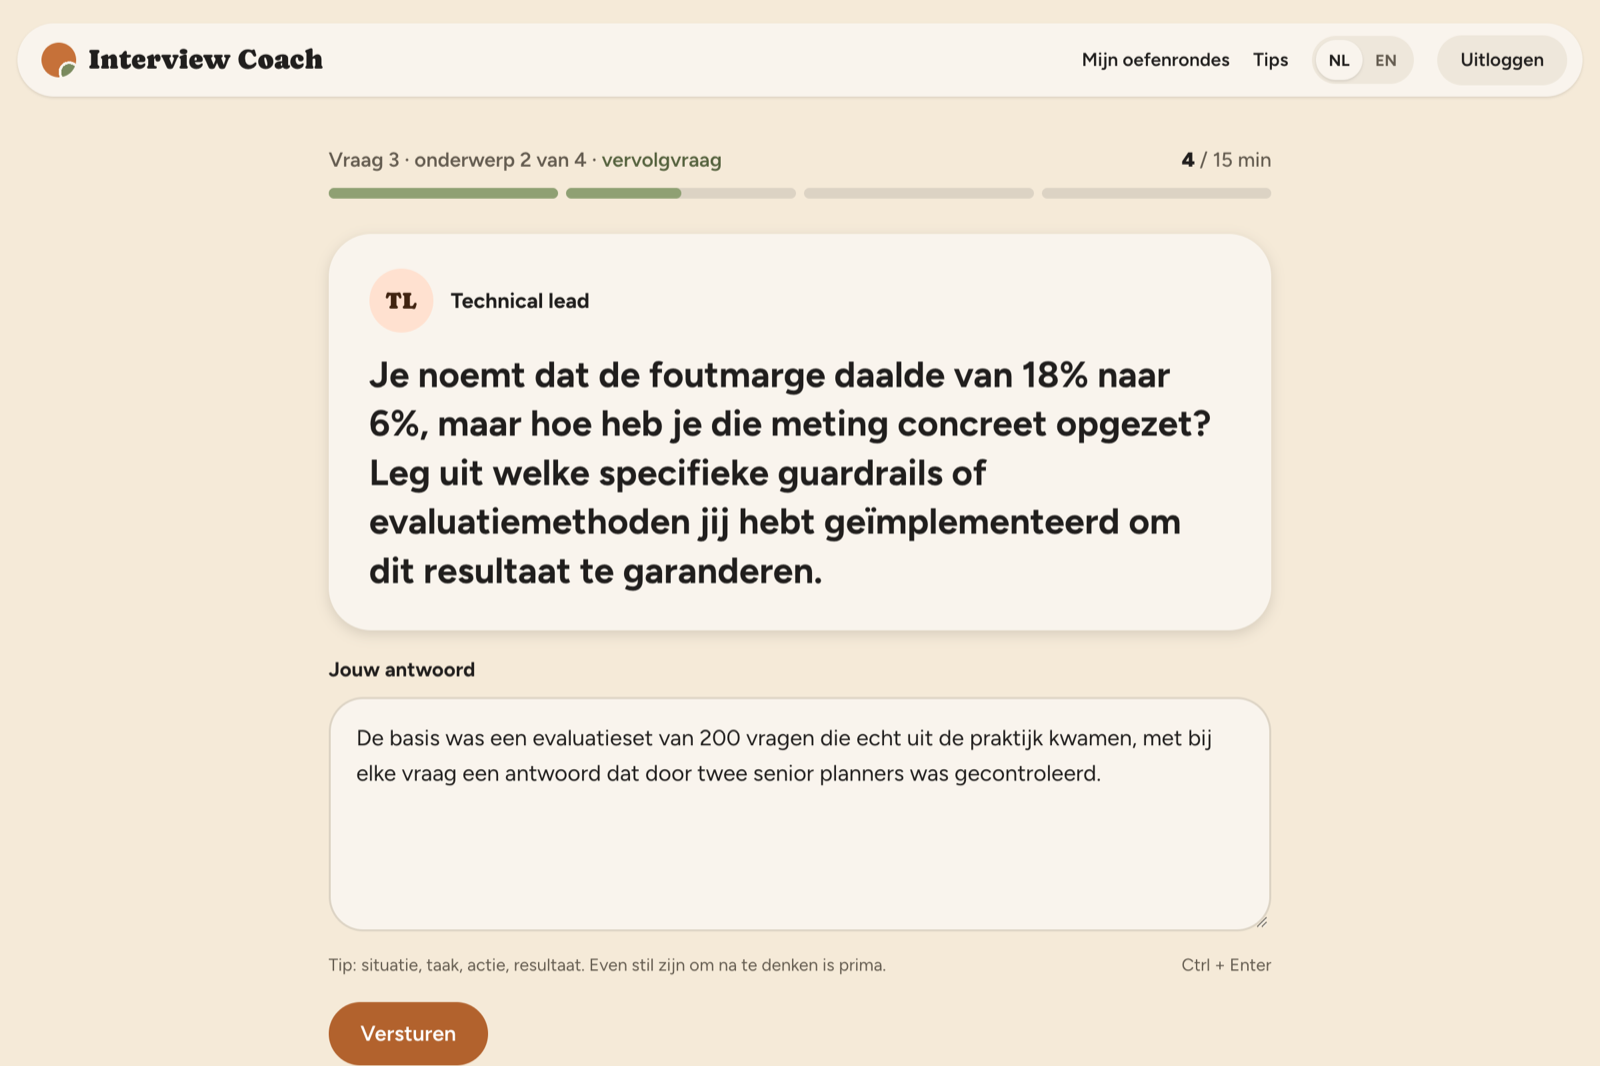
Een vervolgvraag uit deze ronde: de interviewer haakt in op wat de kandidaat net zei. - TerugkijkenScores per antwoord (STAR, concreetheid, resultaat), dekking van de eisen en feedback met bronverwijzingen.Het resultaat van deze ronde staat hieronder ↓
Onder de motorkap
Vijf modellen, elk met een eigen taak, georkestreerd in code. Ruwe tekst gaat alleen naar het lokale model; externe diensten krijgen alleen gepseudonimiseerde tekst.
| Model | Draait | Taak | Waarom dit model |
|---|---|---|---|
| Qwen 3.6 35B-A3B | lokaal | Pseudonimiseert ruwe tekst, haalt de eisen uit de vacature en schrijft elke interviewvraag, in de rol van de interviewer. | Ziet ruwe tekst, dus moet op eigen hardware blijven; open-source, gratis en snel genoeg voor elke vraag. |
| bge-m3 | lokaal | Zoekt per eis het bewijs in het cv (retrieval). | Meertalig (Nederlands en Engels), open-source, draait lokaal. |
| Jev 1.13.0 (TypeSafe) | extern | Beoordeelt elk antwoord (STAR, concreetheid, dekking van eisen, kwaliteit, volgende stap) en controleert elke gegenereerde vraag voordat die getoond wordt. | Getypeerde oordelen mét een waarschijnlijkheid; snel en goedkoop (≈€0,002 per ronde). |
| Claude Sonnet 5.5 | extern | Schrijft het gespreksplan (scenario en interviewers), de briefing en de feedback met bronnen, en geeft een tweede mening als Jev twijfelt. | Zorgvuldige, langere teksten; ongeveer 99% van de kosten. |
| Claude Haiku 4.5 | extern | Schrijft de vraag als de pogingen van het lokale model twee keer door de controle vallen. | Snelle, goedkope terugvaloptie. |
Ontwerpkeuzes
- Privacy afgedwongen in code: externe diensten weigeren ongefilterde tekst, en de prompts behandelen documenten als gegevens, niet als instructies (tegen prompt injection).
- Het goedkoopste model dat de taak goed doet: gemeten ≈€0,20 per ronde van 15 minuten.
- Controles in plaats van blind vertrouwen: elke vraag wordt gecontroleerd, twijfelachtige oordelen krijgen een tweede mening en feedback verwijst naar cv of antwoord.
- Gemeten, niet aangenomen: elke modelaanroep wordt gelogd (rol, model, welk model antwoordde, tokens, kosten, snelheid), met budgetlimieten per ronde en per dag.
Bewust een vaste, door code gestuurde flow in plaats van autonome agents: voorspelbaar, testbaar en de ruwe tekst blijft lokaal. De drempels zijn startwaarden; een evaluatieset om ze af te stemmen staat gepland.
Dit is een echte ronde met een fictieve kandidaat (Sanne Visser) en een fictieve vacature. Alles hieronder is ongewijzigde uitvoer van de modellen.
Gebouwd met FastAPI, htmx, SQLite, Ollama (Qwen), Claude en TypeSafe Jev; draait in Docker achter nginx. · Broncode op GitHub
Briefing
wat de kandidaat vóór het gesprek kreeg
Waarschijnlijke vragen
- Kun je toelichten hoe je de RAG-assistent bij Havenlogistiek hebt opgezet en welke rol taalmodellen daarin speelden?
- Hoe heb je de kwaliteit van LLM-antwoorden gemeten en welke guardrails heb je gebouwd tegen hallucinaties?
- Welke ervaring heb je met CI/CD, Docker en Kubernetes in een productieomgeving?
- Je hebt niet eerder in de publieke sector gewerkt; hoe denk je dat je ervaring met complexe stakeholders (zoals bij de privacy officer) zich vertaalt naar samenwerken met beleidsadviseurs en klantcontactmedewerkers?
- Hoe zou je een AI-toepassing in productie zetten en beheren samen met een platformteam bij de gemeente?
- Hoe ga je om met privacy en de AVG bij het werken met persoonsgegevens van inwoners?
- Wat motiveert je om van de private sector naar de publieke sector over te stappen?
- Hoe leg je technische keuzes uit aan niet-technische collega's, zoals beleidsmedewerkers?
Je sterkste bewijs
Eerlijke gaten
Er is geen directe publieke-sector ervaring, maar de samenwerking met een privacy officer bij DataWerk Consultancy laat zien dat de kandidaat kan werken met gevoelige stakeholders en regelgeving. Benoem dit expliciet als bruggetje en geef aan open te staan voor de andere dynamiek van beleid en politiek in de publieke sector.
Hoewel niet als aparte verantwoordelijkheid genoemd, sluit dit direct aan bij de RAG-assistent die is gebouwd bij Havenlogistiek. Leg uit hoe die ervaring 1-op-1 vertaalt naar het ontwerpen van AI-toepassingen met taalmodellen (RAG/agents) in Python, zonder te claimen al agent-architecturen te hebben gebouwd als dat niet zo is.
Er is ervaring met deployment en beheer samen met een platformteam (Docker, GitHub Actions, Kubernetes), wat een goede basis is. Wees eerlijk dat dit in een ander domein was en geef aan bereid te zijn snel de specifieke infrastructuur van de gemeente te leren.
De evaluatieset en guardrails bij Havenlogistiek zijn sterk relevant bewijs; benoem deze concreet in plaats van generiek te praten over kwaliteit meten.
Er is geen expliciet voorbeeld van het vertalen van beleidsvragen naar technische oplossingen. Gebruik als bruggetje de samenwerking met planners (uitleggen waarom en hoe de assistent werkt) en met de privacy officer, en geef aan hoe je dat zou aanpakken bij beleidsadviseurs.
Sterk gesprek. Houd dit niveau vast.
Statistieken
STAR
STAR: S 71%, T 86%, A 71%, R 71%. Concrete voorbeelden in 71% van de antwoorden; resultaten gekwantificeerd in 43%. Zwakste onderdeel: S.
Kwaliteit
Kwaliteit van de antwoorden (0 = geen antwoord op de vraag, 3 = concreet, gestructureerd, met resultaat): niveau 0: 1, niveau 1: 1, niveau 2: 2, niveau 3: 3.
Dekking van de eisen
| Eis | In documenten | In gesprek |
|---|---|---|
| Afgeronde opleiding op minimaal hbo-niveau in informatica, AI, data science of vergelijkbaar. eis — dit heb je wel, maar je noemde het niet | ✓ sterk | ✗ geen |
| Minimaal 3 jaar werkervaring met Python in productieomgevingen. eis | ✓ sterk | ✓ sterk |
| Aantoonbare ervaring met toepassingen op basis van taalmodellen (bijvoorbeeld RAG). eis | ✓ sterk | ✓ sterk |
| Ervaring met CI/CD, containers (Docker) en versiebeheer (Git). eis — dit heb je wel, maar je noemde het niet | ✓ sterk | ✗ geen |
| Goede beheersing van de Nederlandse taal in woord en geschrift. eis | ✓ sterk | ✓ sterk |
| Ervaring met het evalueren van LLM-output en met guardrails. wens | ✓ sterk | ✓ sterk |
| Kennis van privacywetgeving (AVG) en het werken met persoonsgegevens. wens — dit heb je wel, maar je noemde het niet | ✓ sterk | ✗ geen |
| Ervaring met open-source of lokaal gehoste taalmodellen. wens — dit heb je wel, maar je noemde het niet | ✓ sterk | ✗ geen |
| Ervaring in de publieke sector of met complexe stakeholders. wens — dit heb je wel, maar je noemde het niet | ~ deels | ✗ geen |
Oefenplan
- Werk een concreet voorbeeld uit waarin een release of samenwerking wél tegenslag opliep, en vertel wat jij zelf concreet deed om dat op te lossen (niet alleen 'het platformteam loste het op').Bij de vraag over tegenslag tijdens een release moest je uitwijken naar een ander voorbeeld en gaf je aan dat je Kubernetes-kennis basaal is; dit was je zwakste inhoudelijke antwoord (quality 2.0) en toont een gap in eigen probleemoplossend handelen. antwoordBenoem een gat eerlijk en maak dan de brugVertel het als STAR
- Benoem expliciet je hbo-opleiding informatica en je ervaring met CI/CD, Docker en versiebeheer, ook als het niet direct gevraagd wordt, bijvoorbeeld in je pitch of bij een passende vraag.Twee eisen uit de vacature (hbo-opleiding en CI/CD/Docker-ervaring) zijn niet expliciet benoemd tijdens het gesprek, terwijl je cv hier wel op wijst (severity 0.7). Open met een pitch van één minuut
- Maak je antwoorden concreter en kwantificeer resultaten vaker: noem cijfers, tijdsbesparingen of foutpercentages waar mogelijk.Je specifieke antwoorden scoren goed (71%), maar slechts 43% van je antwoorden bevat kwantificering; concrete cijfers maken je STAR-verhalen overtuigender. Vertel het als STAR
- Vermijd vage, procesmatige formuleringen zoals 'goed communiceren en vroeg betrekken' zonder concreet voorbeeld; ga direct naar een specifieke situatie met actie en resultaat.Je antwoord over samenwerking met het platformteam bleef abstract en leverde de laagste actiescore op binnen STAR; concreetheid direct in het eerste antwoord voorkomt een vervolgvraag die je moet redden. antwoordVertel het als STAR
- Bereid gerichte, scherpe vervolgvragen voor het einde van het gesprek voor, en herhaal of vraag actief door op antwoorden over volgende stappen zodat je concrete afspraken meekrijgt.Je stelde relevante vragen over evaluatie-eigenaarschap en kwaliteitscriteria, maar deze beurt scoorde het laagst (quality 0.0) doordat de vraag over vervolgstappen afgekapt bleef; dit is een gemiste kans om het gesprek sterk af te sluiten. antwoordSluit af met een eigen vraag
Focus voor de volgende keer
- Ervaring voor 'Afgeronde opleiding op minimaal hbo-niveau in informatica…' niet benoemd zwak
- Ervaring voor 'Ervaring met CI/CD, containers (Docker) en versiebeheer…' niet benoemd zwak
Upload het rapport (PDF) bij je volgende ronde om hier opnieuw op te oefenen.
Antwoorden
1 Intake account manager · Kennismaken en motivatie voor de functie en organisatie verkennenWat trekt je aan in deze rol als AI Engineer bij de gemeente, en hoe sluit dat aan bij wat je tot nu toe hebt gedaan? 2.3 / 3
Wat me aantrekt is dat je hier AI bouwt voor mensen die er direct iets aan hebben. Een medewerker die met de juiste regelgeving erbij een inwoner sneller kan helpen, dat vind ik waardevol werk. Ik heb tijdens mijn stage bij Waterschap Oostpolder al even geproefd aan de publieke sector, en dat idee van werken voor inwoners is me altijd bijgebleven. Het sluit ook heel goed aan bij wat ik nu doe. Bij Havenlogistiek heb ik een RAG-assistent gebouwd die planners helpt met douaneregels. Dat is eigenlijk precies het soort toepassing dat jullie beschrijven, alleen met andere regels en andere gebruikers. En de nadruk op betrouwbaarheid en uitlegbaarheid past bij hoe ik werk: bronvermelding bij elk antwoord, en een evaluatieset waar elke release doorheen moet voordat hij live gaat.
kwaliteit: 2.3 · 74%✓ S✓ T✓ A✓ R · Claude✓ concreet✗ gekwantificeerdCV: not_in_cv · Claude✓ overdrijving · Claudetwijfel: 0.0 · 98%✗ eis_1
Sterk
- Je legt concreet de link tussen je RAG-assistent bij Havenlogistiek en de gevraagde toepassing, en noemt specifieke praktijken als bronvermelding en een evaluatieset jouw antwoord
- Je motivatie is persoonlijk gemaakt door te verwijzen naar je stage bij Waterschap Oostpolder als eerste kennismaking met de publieke sector jouw antwoordCV role3 h
Voeg toe
- Je noemt de evaluatieset, maar niet het concrete resultaat: het foutpercentage daalde van 18% naar 6% na drie iteraties, wat je uitlegbaarheid-verhaal nog sterker zou maken CV role1 b2CV p4
- Je hebt niet genoemd dat de RAG-assistent door 40 planners wordt gebruikt en de zoektijd per vraag van 12 naar 3 minuten bracht, wat laat zien dat je impact meet CV p4
- Je ervaring met het samenwerken met een privacy officer aan AVG-pseudonimisering bij DataWerk Consultancy sluit ook goed aan bij werken met gevoelige overheidsdata, maar kwam niet aan bod CV role2 b3
Verken
- Heb je tijdens je stage bij Waterschap Oostpolder al specifiek gewerkt met regelgeving of besluitvorming die inwoners raakt, of was dat vooral technisch (sensordata/pompstoringen)? CV role3 b1
- Heb je een voorbeeld van hoe je zou omgaan met de extra eisen aan transparantie en verantwoording die bij een gemeente gelden, vergeleken met een commerciële omgeving? jouw antwoord
Betere opbouw
- Noem je motivatie: AI bouwen die medewerkers helpt inwoners sneller en beter te bedienen jouw antwoord
- Leg de parallel met je RAG-assistent bij Havenlogistiek: planners geholpen met douaneregels, zoektijd van 12 naar 3 minuten voor 40 gebruikers CV role1 b1CV p4
- Benoem je aanpak voor betrouwbaarheid: verplichte bronvermelding, weigeren bij ontbrekende bron, en een evaluatieset waarmee het foutpercentage van 18% naar 6% daalde CV role1 b2CV role1 b3CV p4
- Verwijs naar je stage bij Waterschap Oostpolder als eerste ervaring met de publieke sector die je motivatie versterkte CV role3 h
- Optioneel: noem je ervaring met AVG/privacy bij DataWerk Consultancy als relevant voor werken met gevoelige overheidsdata CV role2 b3
2 Technical lead · Diepgaand verkennen van ervaring met taalmodeltoepassingen, evaluatie en guardrailsKun je uitleggen hoe je de RAG-assistent voor de planners hebt opgezet, van architectuurkeuzes tot het meten van de kwaliteit van antwoorden? 3.0 / 3
Het vertrekpunt was dat onze 40 planners veel tijd kwijt waren aan zoeken naar douaneregels in pdf's en mailboxen, en dat ze elkaar niet altijd hetzelfde antwoord gaven. Ik moest een assistent bouwen die antwoordt met de juiste bron erbij. Ik ben begonnen met interviews met planners, om te weten welke vragen ze echt stelden. Daarna heb ik in Python met LangChain een RAG-pipeline gebouwd over de regeldocumenten. De belangrijkste architectuurkeuze was dat elk antwoord verplicht een bron toont, en dat de assistent weigert als hij geen bron vindt. We startten met een pilot bij 5 planners en rolden daarna uit naar alle 40. Voor de kwaliteit heb ik een evaluatieset van 200 vragen gemaakt, met antwoorden die twee senior planners hadden gecontroleerd. Die draait bij elke wijziging in CI. Zo ging het aandeel foute antwoorden van 18% naar 6%, en de zoektijd per vraag van 12 naar 3 minuten.
kwaliteit: 3.0 · 99%✓ S✓ T✓ A✓ R✓ concreet✓ gekwantificeerdCV: consistent · 92%✗ overdrijving · Claudetwijfel: 0.0 · 100%✓ eis_3✓ eis_5✓ wens_1✗ wens_3✓ resp_1✓ resp_3
Sterk
- Je legt goed uit hoe je begon met interviews met planners om echte vragen te achterhalen, en beschrijft concrete architectuurkeuzes zoals verplichte bronvermelding en weigeren zonder bron. jouw antwoord
- Je onderbouwt de kwaliteitsverbetering met harde cijfers: van 18% naar 6% foute antwoorden en van 12 naar 3 minuten zoektijd. jouw antwoordCV role1 b2CV p4
Voeg toe
- Je noemt niet dat de deployment via Docker en GitHub Actions naar een Kubernetes-cluster ging, en dat je dit samen met het platformteam beheerde. CV role1 b4
- Je vermeldt niet dat je ervaring hebt met Ollama en lokaal gehoste taalmodellen, wat relevant is gezien de wens naar open-source of lokaal gehoste modellen. CV p7
- Je zegt dat het foutpercentage daalde van 18% naar 6%, maar niet dat dit volgens je cv na drie iteraties gebeurde; dat detail maakt je evaluatieproces concreter. CV p4
Verken
- Heb je voorbeelden van specifieke guardrails tegen hallucinaties naast het weigeren zonder bron, bijvoorbeeld validatie van gegenereerde tekst of prompt-engineering technieken die je hebt toegepast? jouw antwoord
- Gebruikte je open-source of lokale taalmodellen (zoals Ollama) in dit project, of alleen externe API's? CV p7
Betere opbouw
- Startpunt: 40 planners verloren tijd aan zoeken in pdf's/mailboxen en gaven inconsistente antwoorden. jouw antwoord
- Aanpak: interviews met planners, RAG-pipeline in Python met LangChain, pilot bij 5 planners, uitgerold naar 40. jouw antwoord
- Guardrails: verplichte bronvermelding en weigeren bij ontbrekende bron. CV role1 b3jouw antwoord
- Kwaliteit: evaluatieset van 200 vragen gecontroleerd door senior planners, draait in CI, resultaat 18% naar 6% fouten na drie iteraties, zoektijd van 12 naar 3 minuten. jouw antwoordCV role1 b2CV p4
- Deployment: Docker en GitHub Actions naar Kubernetes, beheerd samen met platformteam. CV role1 b4
3 Technical lead · Diepgaand verkennen van ervaring met taalmodeltoepassingen, evaluatie en guardrailsJe noemt dat de foutmarge daalde van 18% naar 6%, maar hoe heb je die meting concreet opgezet? Leg uit welke specifieke guardrails of evaluatiemethoden jij hebt geïmplementeerd om dit resultaat te garanderen. 3.0 / 3
De basis was een evaluatieset van 200 vragen die echt uit de praktijk kwamen, met bij elke vraag een antwoord dat door twee senior planners was gecontroleerd. Bij elke wijziging draait die set automatisch in CI. Per vraag controleren we twee dingen: klopt het antwoord inhoudelijk met het gecontroleerde antwoord, en verwijst de assistent naar de juiste bron. Is een van die twee fout, dan telt het antwoord als fout. Zo kwamen we aan dat percentage. Aan de guardrail-kant heb ik twee dingen ingebouwd. De assistent weigert als er geen passende bron gevonden wordt, en hij toont altijd de bron, zodat een planner het zelf kan nalezen. "Garanderen" zou ik het overigens niet noemen: 6% is nog steeds niet nul. Daarom is die bronvermelding zo belangrijk. De planner blijft zelf de laatste controle.
kwaliteit: 3.0 · 100%✓ S✓ T✓ A✓ R✓ concreet✓ gekwantificeerdCV: consistent · Claude✗ overdrijvingtwijfel: 0.2 · 75%✓ eis_3✓ eis_5✓ wens_1✗ wens_3✓ resp_1✓ resp_3
Sterk
- Je legt heel concreet uit hoe de evaluatieset (200 vragen, gecontroleerd door twee senior planners) werkt en welke twee criteria (inhoudelijke juistheid en juiste bronverwijzing) je gebruikt om een antwoord als fout te tellen. jouw antwoordCV role1 b2
- Mooi dat je zelf nuanceert dat '6%' geen garantie is en dat de planner de laatste check blijft doen - dat toont goed kritisch denken over de beperkingen van je eigen guardrails. jouw antwoord
Voeg toe
- Je noemt niet dat dit resultaat in drie iteraties is bereikt (van 18% naar 6% na drie iteraties) - dat zou goed laten zien hoe je stapsgewijs hebt bijgestuurd op basis van de evaluatieresultaten. CV p4
- Je vermeldt niet dat deze RAG-assistent door 40 planners wordt gebruikt en de zoektijd van 12 naar 3 minuten bracht - dat onderbouwt de impact van je evaluatie- en guardrail-werk extra. CV p4CV role1 b1
Verken
- Kun je een voorbeeld geven van een concrete fout die de evaluatieset opving tijdens een van die drie iteraties, en wat je daarna precies aanpaste? jouw antwoord
- Heb je ook gekeken naar andere evaluatiemethoden dan exact-match op het gecontroleerde antwoord, bijvoorbeeld met een LLM-as-judge of automatische scoring, of was het volledig handmatig gecontroleerd? jouw antwoord
Betere opbouw
- Evaluatieset: 200 praktijkvragen met door twee senior planners gecontroleerde antwoorden, automatisch gedraaid in CI bij elke wijziging. jouw antwoordCV role1 b2
- Foutdefinitie: telt als fout bij onjuiste inhoud of verkeerde bronverwijzing - zo kwam ik op 18% naar 6% na drie iteraties. jouw antwoordCV p4
- Guardrails: verplichte bronvermelding en weigeren bij ontbrekende bron, zodat de planner zelf kan verifiëren. jouw antwoordCV role1 b3
- Impact: gebruikt door 40 planners, zoektijd van 12 naar 3 minuten, met de nuance dat 6% geen garantie is en de planner de laatste controle houdt. CV p4jouw antwoord
4 Hiring manager · Ervaring met productie, samenwerking met platformteam en vertalen van beleidsvragen naar oplossingen, inclusief privacyaspectenJe noemt dat je samenwerkt met het platformteam om toepassingen in productie te brengen, maar op je cv zie ik vooral Docker en Kubernetes zonder expliciete verwijzing naar die samenwerking. Kun je concreet beschrijven hoe jij als developer en het platformteam gezamenlijk een release naar de productieomgeving hebt afgerond? 1.0 / 3
Ja, dat klopt. Met het platformteam werk ik eigenlijk vooral samen door goed te communiceren en ze vroeg te betrekken. Ik probeer altijd duidelijk af te stemmen wat ik nodig heb en wanneer, zodat er geen verrassingen zijn op het moment dat we live gaan. Ik vind het belangrijk om elkaars expertise te respecteren: zij weten meer van het cluster, ik meer van de applicatie. Als je elkaar daarin serieus neemt en regelmatig overlegt, gaat een release meestal vrij soepel.
kwaliteit: 1.0 · 100%✗ S · Claude✓ T✗ A · Claude✗ R · Claude✗ concreet✗ gekwantificeerdCV: consistent · Claude✗ overdrijving? twijfel: 0.4 · 44%✗ eis_2✗ eis_4✗ wens_2✗ wens_4✗ resp_2 · Claude✗ resp_4
Sterk
- Je benoemt duidelijk het principe van vroeg afstemmen en elkaars expertise respecteren ('zij weten meer van het cluster, ik meer van de applicatie') jouw antwoord
Voeg toe
- Je noemt niet dat je concreet Docker en GitHub Actions gebruikt voor deployment naar een Kubernetes-cluster, wat je samen met het platformteam beheert CV role1 b4
- Je laat de guardrails (bronvermelding verplicht, weigeren bij ontbrekende bron) die je toevoegde niet terugkomen als concreet voorbeeld van samenwerking rond productiekwaliteit CV role1 b3
Verken
- Heb je een concreet voorbeeld van een specifieke release waarbij jij en het platformteam samen een probleem oplosten of een deployment afrondden voor de RAG-assistent? CV role1 hCV role1 b4
- Kun je vertellen hoe de afstemming er in de praktijk uitzag, bijvoorbeeld welke afspraken of overlegmomenten er waren rond het Kubernetes-cluster? CV role1 b4
Betere opbouw
- Noem het concrete project: de RAG-assistent voor planners bij Havenlogistiek CV role1 b1
- Beschrijf de technische samenwerking: deployment met Docker en GitHub Actions naar Kubernetes, beheer samen met platformteam CV role1 b4
- Leg uit hoe je afstemde: vroeg betrekken, duidelijk communiceren wat je nodig had en wanneer jouw antwoord
- Benoem het resultaat: soepele releases doordat expertise over cluster en applicatie gecombineerd werd jouw antwoord
5 Hiring manager · Ervaring met productie, samenwerking met platformteam en vertalen van beleidsvragen naar oplossingen, inclusief privacyaspectenJe noemt dat je vroeg communiceert en afstemt om verrassingen te voorkomen. Kun je een specifiek voorbeeld geven waarin het platformteam later tegenslag had tijdens de release, en wat jij concreet hebt gedaan om die blokkade op te lossen? 2.0 / 3 · Claude
Eerlijk gezegd heb ik bij Havenlogistiek geen grote blokkade meegemaakt waarbij een release echt vastliep. Mijn Kubernetes-kennis is ook vrij basaal, dus als er iets op clusterniveau speelde, loste het platformteam dat zelf op. Het voorbeeld dat er het dichtst bij komt is van DataWerk. Daar moest ik voor een energieklant een batchjob ombouwen naar een streaming-opzet met Airflow en PostgreSQL. Het risico was dat bestaande rapportages zouden breken. Daarom hebben we oud en nieuw twee weken naast elkaar laten draaien en de uitkomsten elke dag vergeleken. Verschillen zochten we meteen samen uit, voordat we de oude job uitzetten. Uiteindelijk ging de overstap zonder verstoring, en de doorlooptijd van rapportages ging van een dag naar 15 minuten. Die aanpak, parallel draaien en vergelijken, zou ik bij een lastige release met een platformteam ook zo toepassen.
kwaliteit: 2.0 · Claude✓ S✓ T✓ A✓ R✓ concreet✓ gekwantificeerdCV: consistent · Claude✗ overdrijving? twijfel: 1.2 · 47%✓ eis_2 · Claude✗ eis_4 · Claude✗ wens_2✗ wens_4 · Claude✗ resp_2 · Claude✓ resp_4 · Claude
Sterk
- Je bent eerlijk over wat je wel en niet zelf hebt gedaan bij het platformteam, en het DataWerk-voorbeeld met 'oud en nieuw twee weken naast elkaar laten draaien en de uitkomsten elke dag vergeleken' laat een concrete, zorgvuldige aanpak zien. jouw antwoord
Voeg toe
- Je noemt niet dat je bij Havenlogistiek zelf deployt met Docker en GitHub Actions naar een Kubernetes-cluster en dit beheer samen met het platformteam doet, wat juist direct relevant is voor deze vraag. CV role1 b4
- Je gebruikt de guardrails die je bij de RAG-assistent toevoegde (bronvermelding, weigeren bij ontbrekende bron) niet als voorbeeld van hoe je risico's bij productie-releases mitigeert. CV role1 b3
Verken
- Heb je bij Havenlogistiek weleens meegemaakt dat een deployment naar het Kubernetes-cluster faalde of vertraging opliep, en wat deed je toen concreet richting het platformteam? CV role1 b4
- Is er een moment geweest waarop je vroegtijdig moest afstemmen met het platformteam om een probleem te voorkomen voordat het escaleerde? CV role1 b4
Betere opbouw
- Wees eerlijk: bij Havenlogistiek geen grote blokkade meegemaakt, clusterniveau-issues loste het platformteam zelf op jouw antwoord
- Noem wel dat je daar samen met het platformteam deployment doet via Docker en GitHub Actions naar Kubernetes, en beschrijf hoe die samenwerking normaal verloopt CV role1 b4
- Gebruik het DataWerk-voorbeeld als illustratie van je aanpak: oud en nieuw twee weken parallel draaien en dagelijks vergelijken om risico's te beperken jouw antwoordCV role2 b2
- Sluit af met resultaat: geen verstoring bij de overstap en doorlooptijd van rapportages van een dag naar 15 minuten jouw antwoordCV p5
6 Hiring manager · Ervaring met productie, samenwerking met platformteam en vertalen van beleidsvragen naar oplossingen, inclusief privacyaspectenJe noemt dat je bij DataWerk het risico van brekende rapportages hebt geminimaliseerd door oud en nieuw twee weken naast elkaar te draaien. Welke specifieke technische mechanismen of alerting-regels heb jij hierin opgezet om de verschillen tussen de batch- en streaming-output automatisch te detecteren? 2.9 / 3
Het was eerlijk gezegd vrij eenvoudig, maar het werkte. Ik heb in Airflow een aparte taak toegevoegd die elke ochtend draaide, nadat beide versies klaar waren. Die taak voerde vergelijkingsqueries uit in PostgreSQL: per rapportage het aantal rijen, en per klant en per dag de totalen van de belangrijkste waarden. Week een getal meer af dan een kleine drempel, dan faalde de taak en kreeg ik een melding. Dan ging ik handmatig uitzoeken waar het verschil vandaan kwam. Meestal ging het om timing, bijvoorbeeld data die in de streaming-versie net iets later binnenkwam dan in de batchjob. Pas toen we een week achter elkaar geen afwijkingen meer hadden, zijn we overgestapt op de nieuwe opzet.
kwaliteit: 2.9 · 89%✓ S✓ T✓ A✓ R✓ concreet✗ gekwantificeerdCV: not_in_cv · Claude✗ overdrijving? twijfel: 0.4 · 35%✓ eis_2 · Claude✗ eis_4✗ wens_2✗ wens_4✓ resp_2✗ resp_4
Sterk
- Je geeft een concreet en specifiek antwoord op de technische vraag: een Airflow-taak die vergelijkingsqueries in PostgreSQL uitvoerde op rijaantallen en totalen per klant/dag, met een drempelwaarde en handmatige uitzoekprocedure bij afwijkingen. jouw antwoord
Voeg toe
- Je noemt niet dat je bij DataWerk ook samenwerkte met een privacy officer aan het pseudonimiseren van klantdata volgens de AVG - relevant gezien de wens naar privacywetgeving-kennis in deze rol. CV role2 b3
- Je vermeldt niet dat deze pipelines voor drie klanten in energie en logistiek werden gebouwd, wat context geeft over de schaal en complexiteit van de omgeving. CV role2 b1
Verken
- Heb je bij het opzetten van deze vergelijkingsqueries ook rekening gehouden met persoonsgegevens of pseudonimisering, gezien je AVG-ervaring bij dezelfde klant? Zo ja, hoe borgde je dat in deze validatie-opzet? jouw antwoord
- Is de drempelwaarde voor afwijkingen door jou zelf bepaald, en hoe heb je die gekalibreerd zodat je niet te veel valse meldingen kreeg? jouw antwoord
Betere opbouw
- Ik voegde een dagelijkse Airflow-taak toe die na afronding van batch en streaming vergelijkingsqueries in PostgreSQL draaide. jouw antwoord
- Deze queries vergeleken rijaantallen en totalen van kernwaarden per klant en per dag tussen beide versies. jouw antwoord
- Bij afwijking boven een drempel faalde de taak en kreeg ik een melding, waarna ik handmatig de oorzaak analyseerde - vaak timing-verschillen in de streaming-instroom. jouw antwoord
- Pas na een week zonder afwijkingen zijn we overgestapt op de nieuwe streaming-opzet, wat het risico op brekende rapportages minimaliseerde. jouw antwoord
- Daarnaast werkte ik bij deze klant samen met een privacy officer aan het pseudonimiseren van klantdata volgens de AVG, wat relevant is voor het werken met persoonsgegevens in productieomgevingen. CV role2 b3
7 Intake account manager · Afsluiting en ruimte voor vragen van de kandidaatHeb je nog vragen over het team, de rol of de volgende stappen in dit proces? 0.0 / 3 · Claude
Ja, graag. Ik heb er twee over de rol. Hoe bepalen jullie wanneer een AI-toepassing goed genoeg is om aan inwoners voor te leggen? Ik ben benieuwd of daar vaste criteria voor zijn, of dat jullie dat per toepassing afwegen. En wie in het team is eigenaar van de evaluatie van de modeluitvoer zodra iets live staat? In mijn ervaring zakt de kwaliteit daar makkelijk weg als niemand er echt verantwoordelijk voor is. En tot slot nog kort over de volgende stappen: wanneer hoor ik van jullie, en hoe ziet een eventuele tweede ronde eruit?
kwaliteit: 0.0 · Claude✗ S · Claude✗ T✗ A · Claude✗ R✗ concreet · Claude✗ gekwantificeerdCV: consistent · 82%✗ overdrijvingtwijfel: 0.1 · 81%
Sterk
- Je stelde gerichte, inhoudelijke vragen over de rol, zoals wie eigenaar is van de evaluatie van modeluitvoer zodra iets live staat jouw antwoord
- Je legde je vraag duidelijk aan je eigen ervaring, met 'in mijn ervaring zakt de kwaliteit daar makkelijk weg als niemand er echt verantwoordelijk voor is' jouw antwoord
Voeg toe
- Je had je vraag over evaluatie-eigenaarschap kunnen onderbouwen met je eigen ervaring: je zette zelf een evaluatieset van 200 vragen op waarbij het foutpercentage daalde van 18% naar 6% na iteraties, dat had je vraag concreter en geloofwaardiger gemaakt CV role1 b2
- Je noemde guardrails niet, terwijl je bij Havenlogistiek zelf bronvermelding en weigeren bij ontbrekende bron als guardrail toevoegde, dit sluit direct aan bij je vraag over kwaliteitsborging CV role1 b3
Verken
- Was er bij Havenlogistiek een duidelijke eigenaar voor de evaluatie na livegang, of ontbrak die juist en is dat waar je vraag vandaan komt? jouw antwoord
Betere opbouw
- Stel je vraag over 'goed genoeg' criteria, en verwijs kort naar je eigen evaluatieset van 200 vragen als referentiepunt jouw antwoordCV role1 b2
- Vraag naar eigenaarschap van evaluatie na livegang, en noem dat je zelf guardrails zoals bronvermelding en weigeren bij ontbrekende bron hebt toegevoegd om kwaliteit te bewaken jouw antwoordCV role1 b3
- Sluit af met je vraag over de volgende stappen en timing van een eventuele tweede ronde jouw antwoord
Zelf proberen
Wil je het met een echte vacature en je eigen cv proberen? Dit kun je verwachten:
- Je maakt een account aan met een gebruikersnaam en wachtwoord; een e-mailadres is niet nodig.
- Je uploadt een vacature en je cv; na ongeveer 3 minuten voorbereiding volgt een gesprek van 15 tot 45 minuten.
- Namen en contactgegevens gaan eerst door het lokale model; rondes worden na 30 dagen verwijderd.